L'essentiel en 3 points
1. Un réseau de neurones, ce sont des milliers de boutons. L'entraînement les tourne pour que la machine se trompe moins, et elle répond en pourcentages : elle prédit, elle ne sait pas.
2. La machine ne voit que ce que contiennent ses fiches. Elle ne devine pas un critère absent, apprend de la diversité des exemples et non de leur nombre, et peut briller en test puis s'effondrer en production.
3. Un bon score ne suffit pas : demandez comment elle a été testée, quelles erreurs elle commet et ce qu'elles coûtent. Votre LLM fonctionne sur le même principe, avec des mots.
Série « … sans être ingénieur », par Samuel Arnod-Prin
Promis : pas besoin de devenir mathématicien. Nous allons construire une machine qui reconnaît des animaux, la vendre à nos clients et découvrir avec eux ce qui se passe quand elle se trompe. À la fin, vous saurez comment elle apprend, pourquoi elle se trompe, et quelles questions poser avant de lui faire confiance.
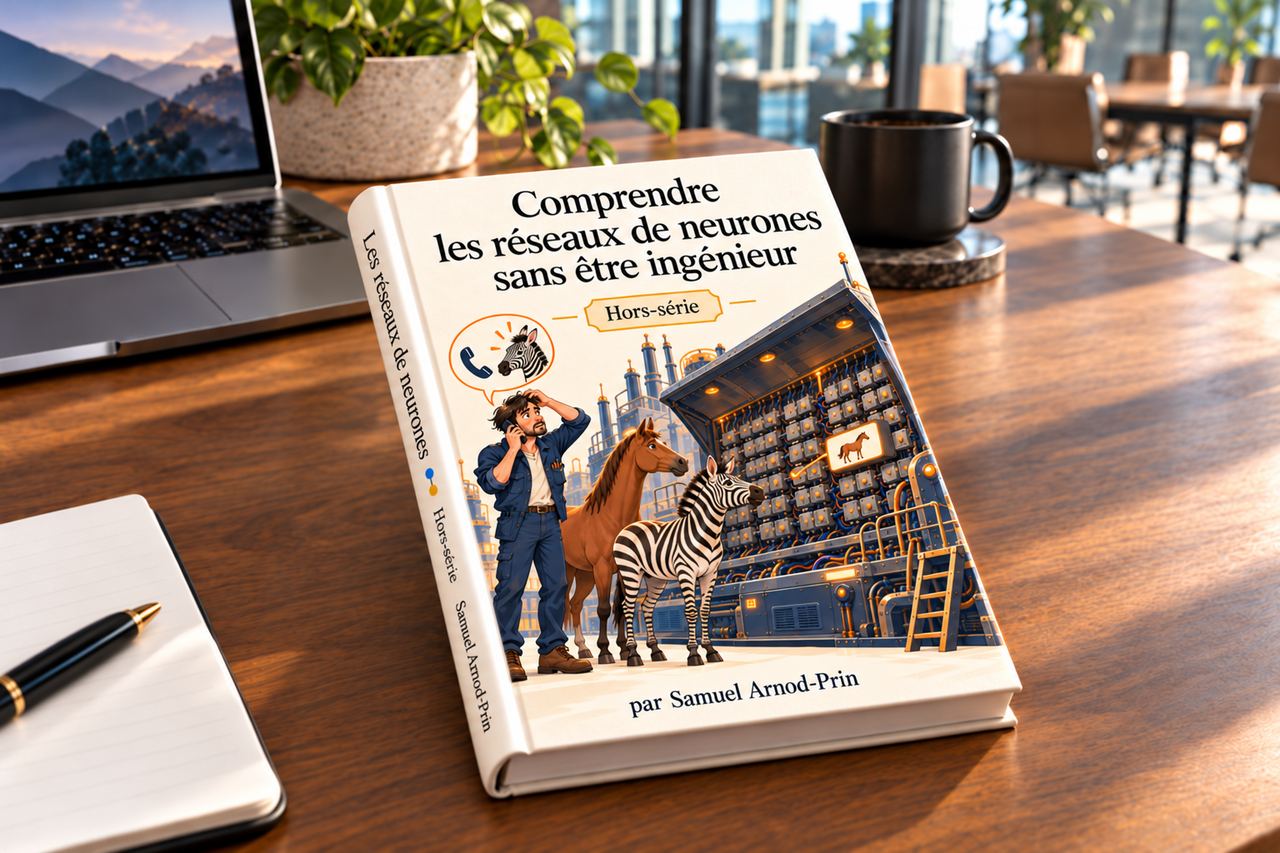
Voici une grande machine faite de milliers de petites boîtes reliées entre elles. Chaque boîte a des réglages, comme de petits boutons de volume. Ces boîtes sont nos neurones artificiels ; ensemble, elles forment un réseau de neurones.
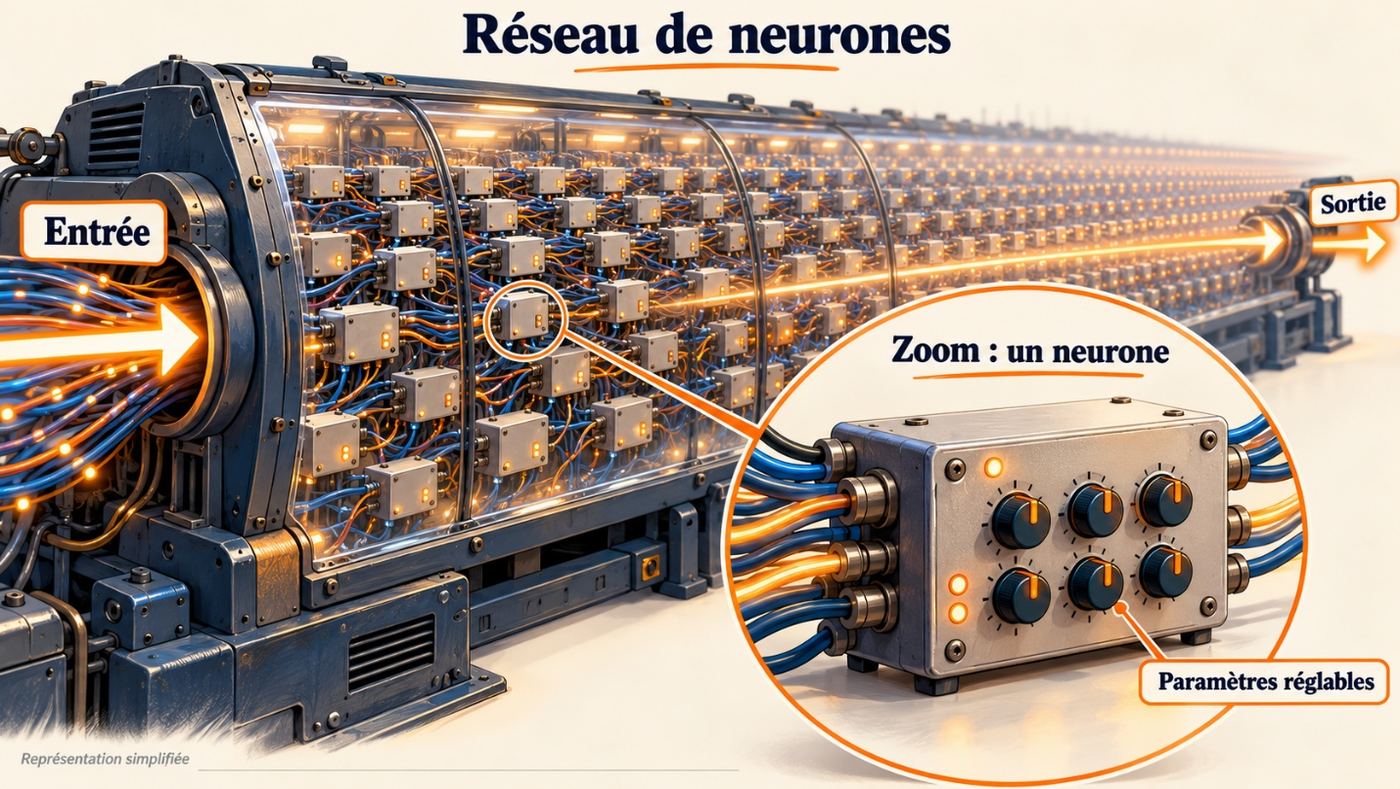
Nous lui présentons un animal inconnu. Elle répond : chien 80 %, chat 15 %, loup 3 %, autres 2 %. Elle penche pour le chien, sans certitude.
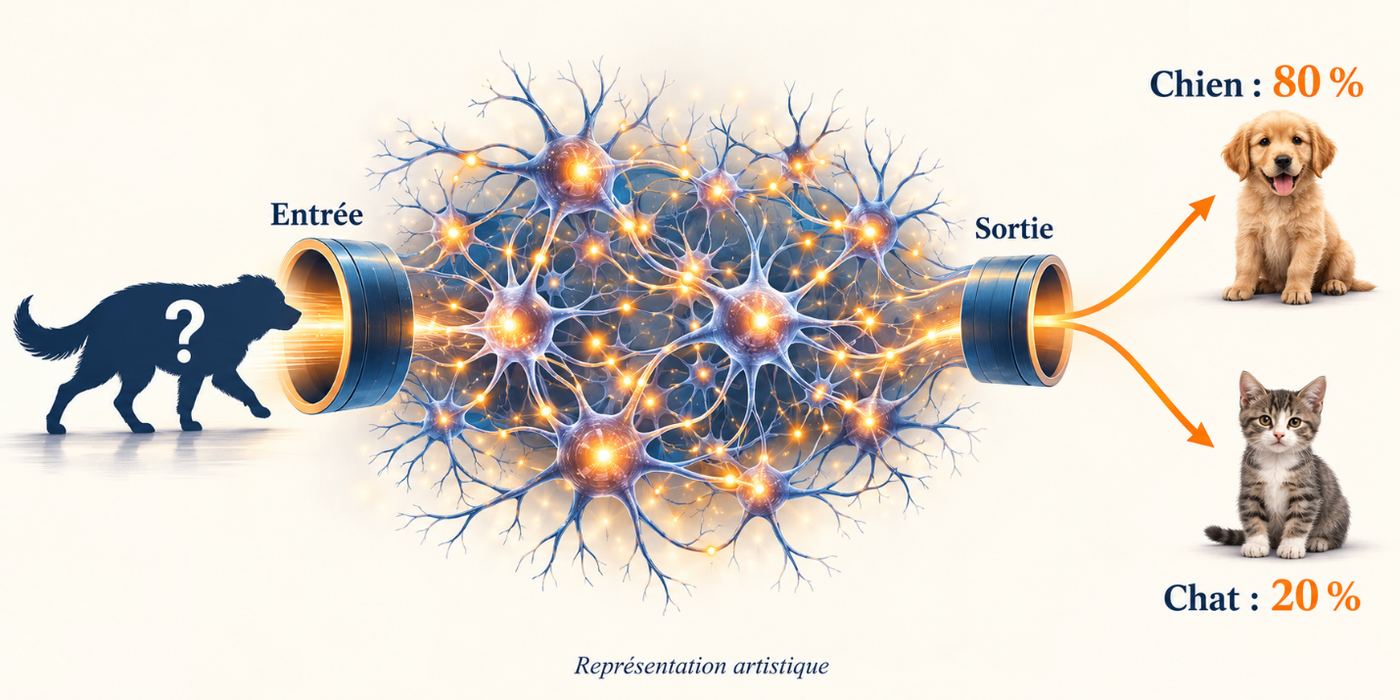
Retenez bien cette réponse en pourcentages : nous la retrouverons à la fin, au cœur de votre LLM.
Mais comment a-t-elle appris à répondre ainsi ? Remontons au début.
Nous ne lui montrons pas de photo. Nous lui donnons une liste de caractéristiques :
Pour elle, l'animal n'est qu'une suite de nombres. La photo est là pour nous.
Au départ, la machine n'a jamais vu d'animal : ses boutons sont réglés au hasard. Nous lui présentons un chien. Elle répond : licorne 60 %, poisson rouge 35 %… On ne va pas encore lui confier le zoo.
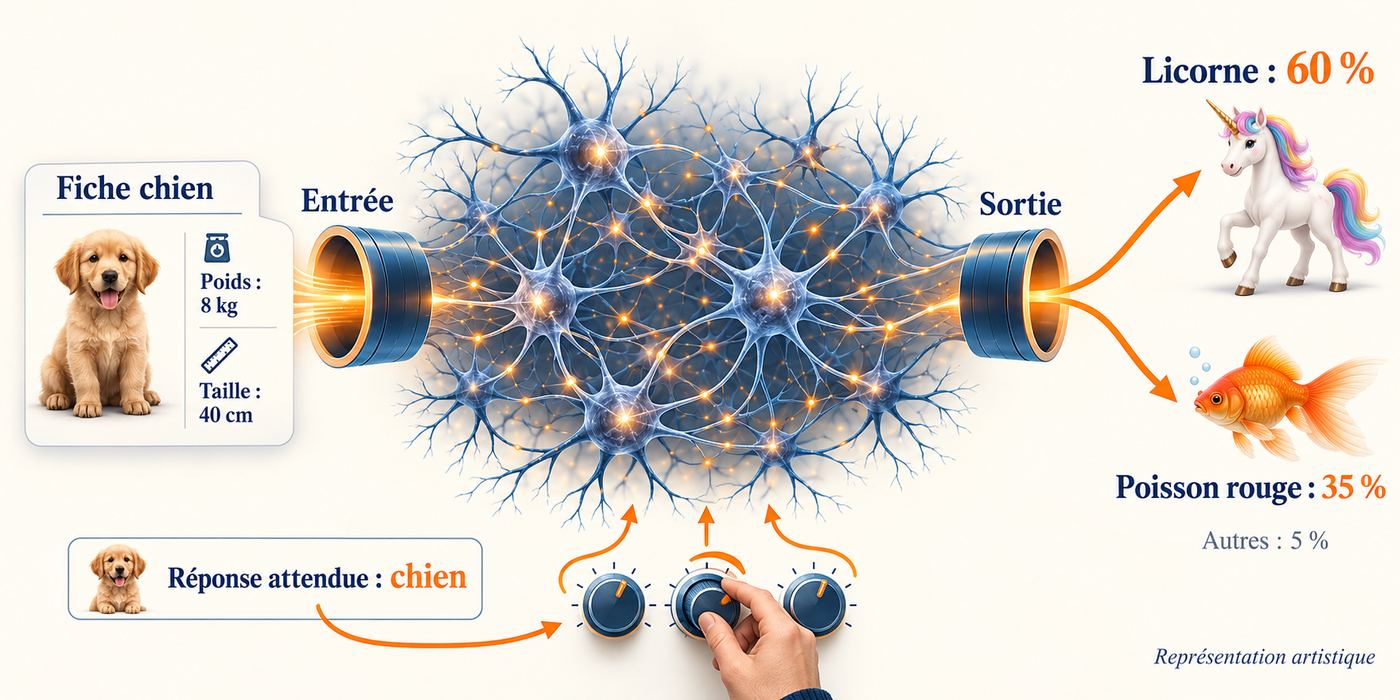
Nous, nous connaissons la bonne réponse. Le programme d'entraînement compare sa réponse à la vérité, mesure l'écart, puis tourne légèrement chaque bouton dans le sens qui réduit cet écart.
On recommence avec des milliers d'animaux, et on repasse plusieurs fois sur les mêmes. Peu à peu, la machine se trompe moins.
C'est tout : apprendre, ici, c'est tourner des boutons pour se tromper moins.
La machine reconnaît maintenant les animaux de ses exercices. Mais sait-elle reconnaître des animaux en général, ou seulement ceux qu'elle a déjà vus ?
Pour le savoir, nous avions mis de côté des animaux dont nous connaissons la réponse, mais qu'elle n'a jamais vus. C'est l'examen. Si elle le réussit, nous pouvons l'utiliser sur de nouveaux animaux, sans avoir écrit une seule règle. En gardant en tête qu'elle peut se tromper.
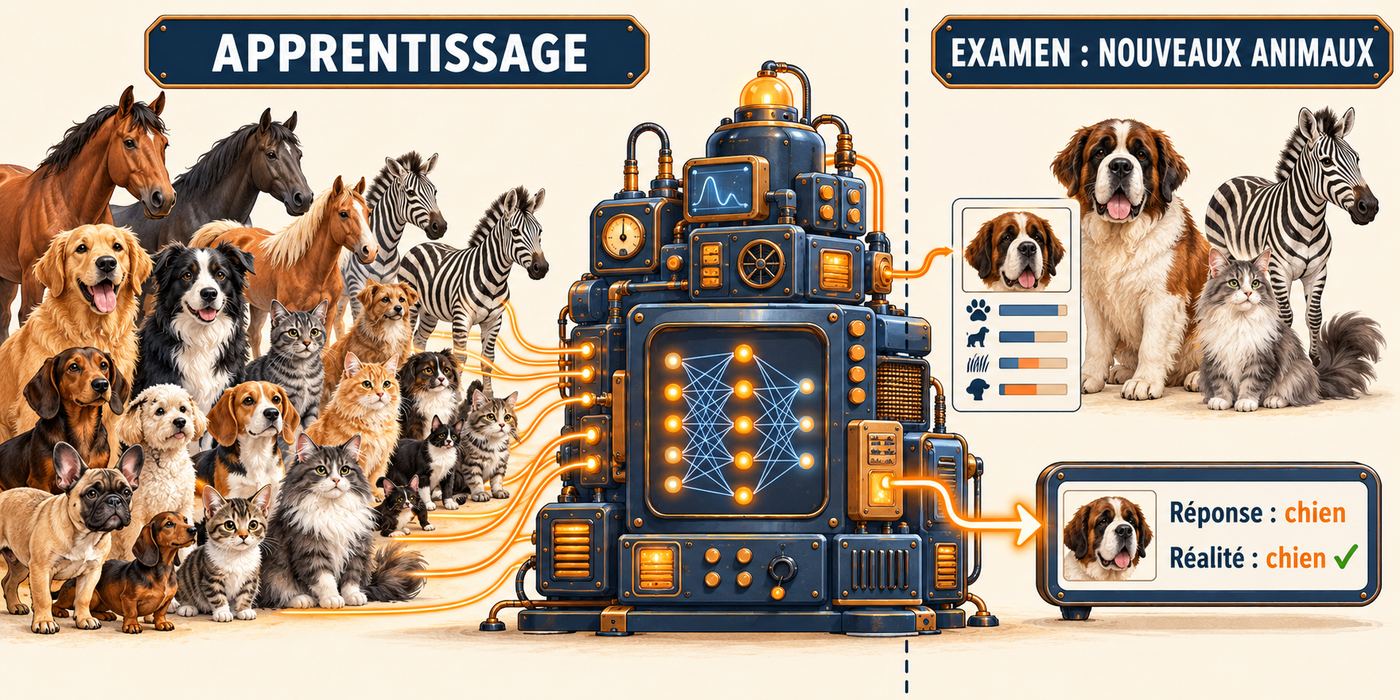
Nous sauvegardons la machine avec la position de tous ses boutons : ce sont ses paramètres. Avec la structure du réseau et la façon de préparer les fiches, cela forme notre modèle entraîné.
Nous le vendons comme détecteur d'animaux. Ça y est : nous sommes une entreprise d'IA ! Le champagne est au frais. Le téléphone sonne…
« Bonjour, votre machine prend tous mes zèbres pour des chevaux. »
« Ah… ce n'est pas idéal. »
« Vous pouvez ajouter un neurone qui détecte les rayures ? »
« Bien sûr ! Je vais le mettre juste à côté du neurone qui détecte les sabots… »
« Vous ne savez pas où il est ? »
« Non. »
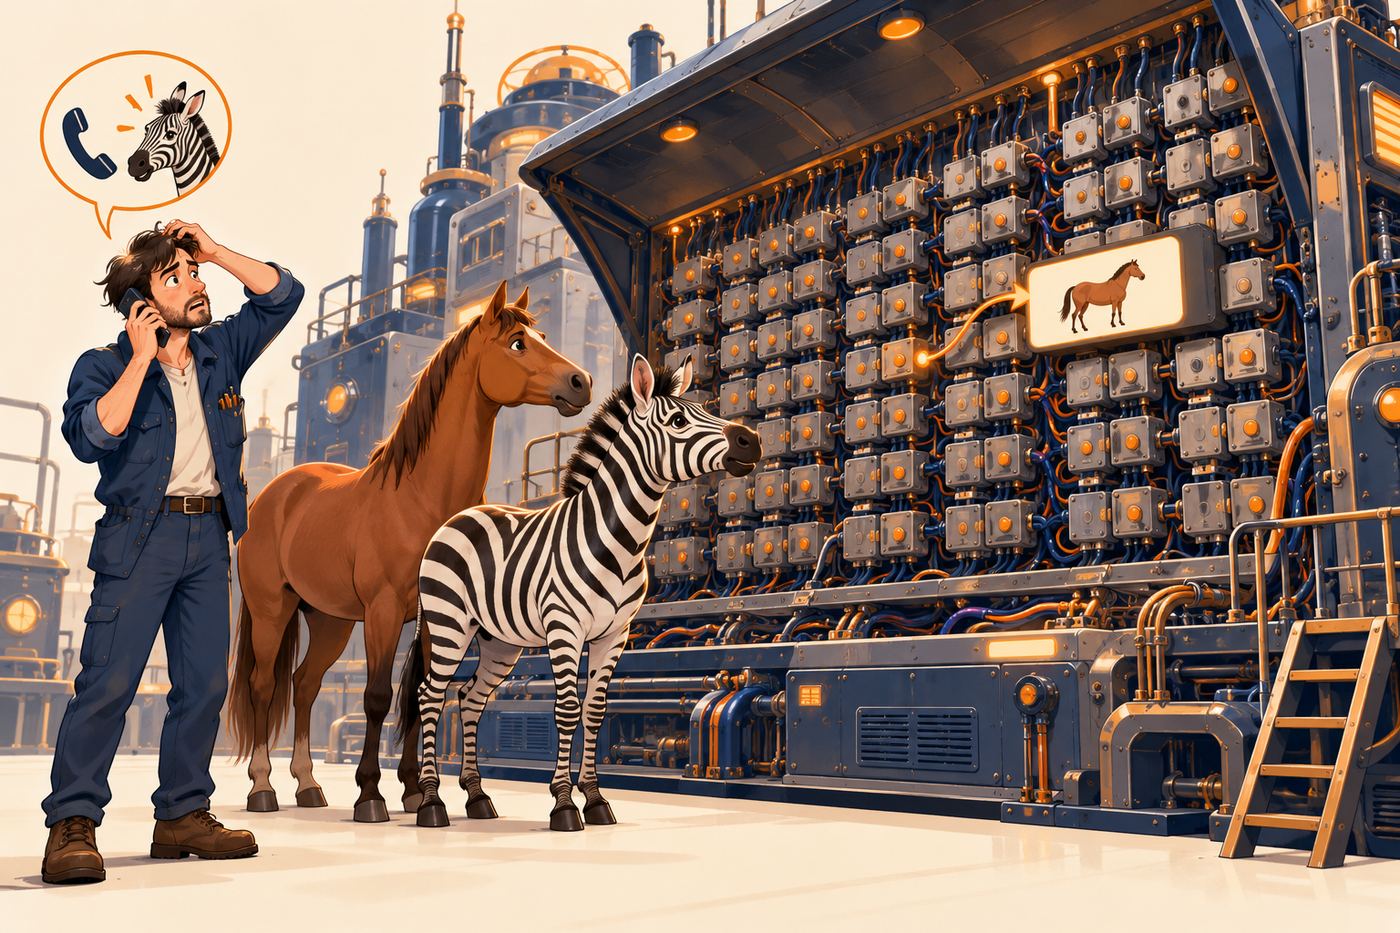
Ouvrons le capot. Nous n'y trouvons pas de petite boîte étiquetée « sabots » ou « rayures ». Ce que la machine sait est réparti dans des milliers de réglages, mélangés.
Chaque calcul est connu, un par un. Ce qui est difficile, c'est d'en tirer une explication simple pour un humain. Des chercheurs y travaillent, mais personne n'a encore le mode d'emploi complet d'un grand modèle.
Pour comprendre ce que font ces boutons, construisons une machine beaucoup plus petite.
Deux critères, un neurone. Reprenons nos chats et nos chiens, avec seulement leur poids et leur taille. Chaque animal devient un point sur un graphique. Nous traçons une ligne pour séparer les chats des chiens.
Un seul neurone sait tracer cette ligne. Il reçoit deux nombres, le poids et la taille, et possède trois boutons : un pour le poids, un pour la taille, et un décalage. Ensemble, ces trois boutons définissent la ligne.
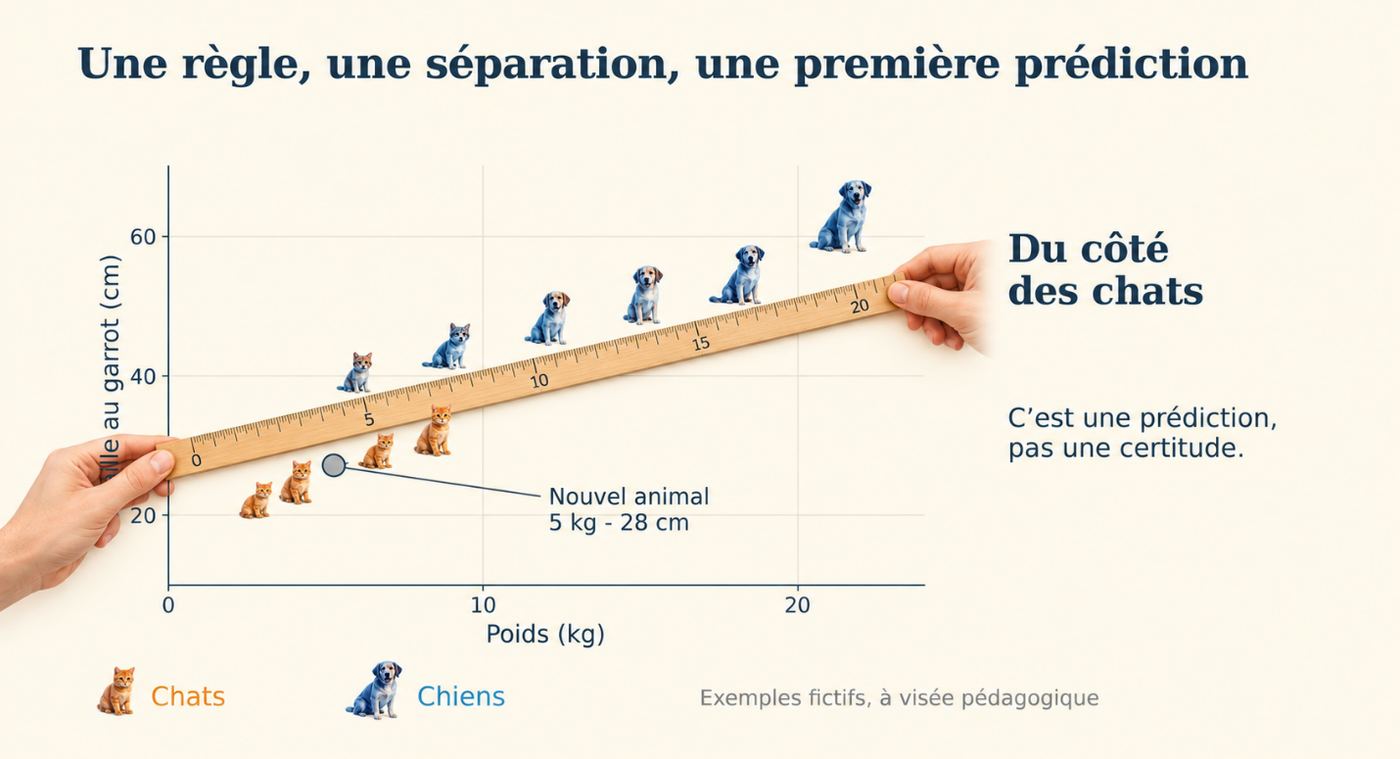
Tourner les boutons, c'est déplacer et incliner la règle. L'entraînement tourne les boutons jusqu'à ce que la ligne sépare au mieux les chats des chiens. Et voilà : notre neurone a appris. Ici, on peut encore lire les trois boutons et comprendre exactement ce qu'il fait.
Trois critères et plus. Ajoutons la longueur des oreilles. Nos points flottent maintenant dans un cube, et la ligne devient une feuille placée dans ce cube.
Avec vingt critères, le neurone calcule toujours aussi bien, mais nous ne pouvons plus rien dessiner. Et quand une séparation simple ne suffit pas, on relie plusieurs neurones entre eux pour tracer des frontières plus tordues.
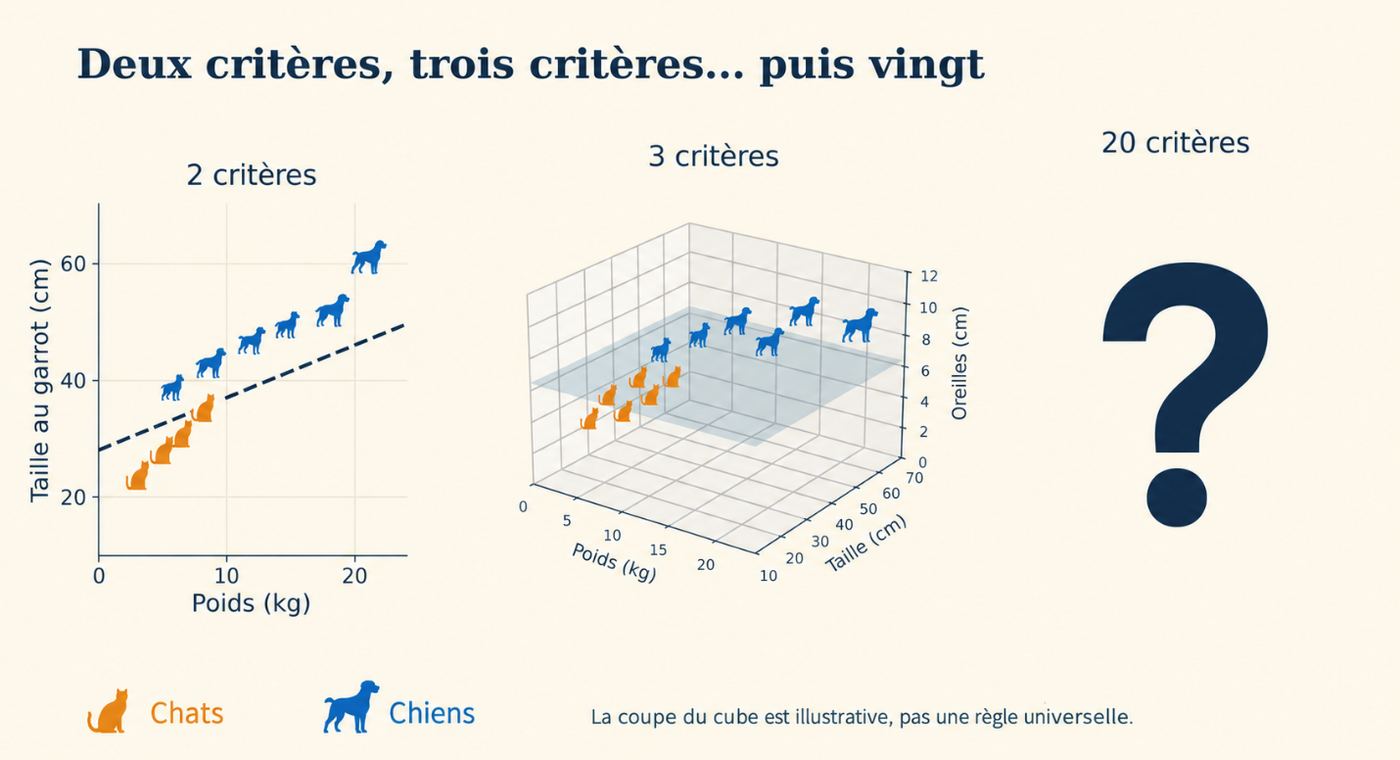
C'est là qu'on perd la lecture directe. Dans la grande machine, on ne lit plus la réponse dans les boutons. On peut en revanche la tester sur de nouveaux cas et examiner ses erreurs.
Relisons nos fiches : poids, taille, oreilles, queue… et rien sur les rayures. Même si nous avions trouvé le neurone des sabots, il n'aurait rien pu faire : personne n'avait parlé des rayures à la machine. Pour elle, un zèbre et un cheval ont la même fiche.
Nous ajoutons donc le critère « rayures », nous préparons des exemples de chevaux, de zèbres et d'autres animaux, et nous réentraînons. Puis nous vérifions qu'elle reconnaît toujours bien les autres.
Première leçon : la machine ne devine pas ce qu'aucun critère ne lui dit.
Vos saint-bernards sont des lions.
« Votre machine prend mes saint-bernards pour des lions ! »
« Nous l'avions surtout entraînée sur de petits chiens… »
Un chien de 80 kg, elle n'en avait jamais vu. Elle a cherché ce qui lui ressemblait le plus dans ses souvenirs : un gros animal à quatre pattes. Deuxième leçon : les exemples doivent couvrir les situations réelles, pas seulement les plus courantes.
98 % de réussite… et aucun loup reconnu.
« Votre machine réussit 98 % des classements, mais elle n'a reconnu aucun de mes loups ! »
« Combien aviez-vous d'animaux ? »
« Quatre-vingt-dix-huit chiens et deux loups. Elle a répondu “chien” à chaque fois. »
Une machine qui répond toujours « chien » obtient 98 %. Le score est excellent, la machine est inutile.
Et toutes les erreurs ne se valent pas. Un chien pris pour un loup, c'est une fausse alerte. Un loup pris pour un chien, c'est la bergerie. Troisième leçon : ne demandez pas seulement le score, demandez quelles erreurs la machine commet et ce qu'elles coûtent.
Le même client cent fois.
« Nous avons 10 000 clients dans le CRM, l'entraînement devrait être solide. »
« Combien de clients différents ? »
« … Il y a beaucoup de doublons. »
Cent fois la même fiche n'apprend rien de neuf à la machine. Pire : elle accorde cent fois plus d'importance à ce client. Ce qui compte, ce n'est pas le nombre de lignes, c'est la diversité des cas.
Le critère qui ne change rien.
« J'ai retiré le nombre de pattes : les résultats sont les mêmes ! »
« Tous nos chats, chiens et chevaux avaient quatre pattes… »
Un critère peut être exact sans rien apprendre à la machine. Et quand un critère varie mais que son retrait ne change rien, un autre porte souvent déjà la même information.
Le critère à expliquer.
« Les prédictions de retard sont meilleures avec la température nocturne à Honolulu. »
« Avant d'ouvrir une succursale à Hawaï, vérifions sur d'autres projets ! »
Un critère peut aider à prédire sans être la cause de quoi que ce soit. Une coïncidence, ça arrive. Si le gain ne se retrouve pas sur de nouveaux cas, c'en était une.
La machine qui apprend ses fiches par cœur.
« Elle reconnaît presque tous les animaux de l'entraînement ! »
« Et ceux gardés pour l'examen ? »
« Beaucoup moins… »
La machine a appris ses exercices par cœur au lieu de comprendre ce qui distingue un chat d'un chien. C'est le surapprentissage : brillante à l'entraînement, décevante dans la vraie vie. C'est exactement pour cela qu'on garde des animaux pour l'examen.
La donnée qui vient du futur.
« La machine prédit les retards à merveille ! »
« Quels critères avez-vous utilisés ? »
« Le budget initial, l'équipe… et la date réelle de livraison. »
« Mais le projet est déjà terminé ! »
C'est le piège le plus coûteux en entreprise. Une prédiction n'a de valeur que si elle utilise uniquement ce qu'on sait au moment où l'on prédit. Sinon, le modèle brille en test et s'effondre en production.
Remplaçons la fiche « animal » par une fiche « projet ». La question devient : ce projet finira-t-il avec plus d'un mois de retard, oui ou non ? Deux catégories, exactement comme chien ou loup.
Nous choisissons le moment où nous voulons prédire : par exemple, trois mois après le démarrage. Chaque fiche ne contient que ce que l'on savait à ce moment-là : budget, taille de l'équipe, nombre de changements de périmètre, avancement à trois mois… La réponse à apprendre, c'est ce qui s'est vraiment passé.
Nous entraînons la machine sur une partie de nos projets terminés, et nous gardons les autres pour l'examen.
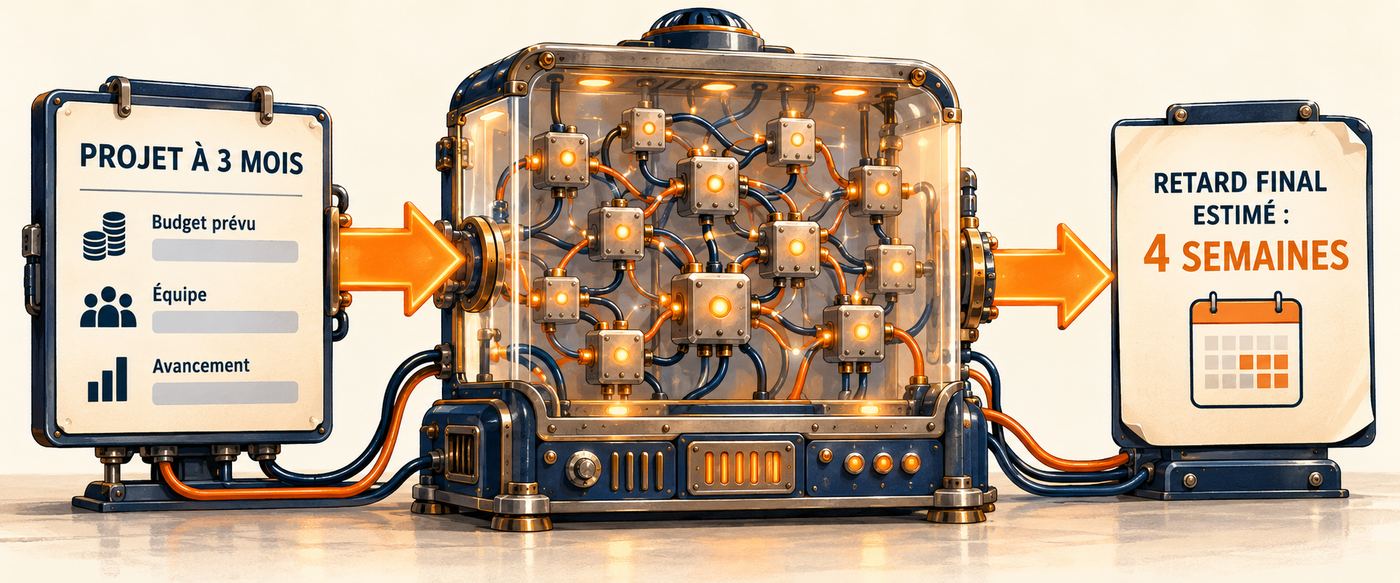
Si elle se trompe souvent, posons les bonnes questions : projets comparables ? exemples variés ? critères utiles ? retards correctement mesurés ? Le problème vient souvent des données avant de venir du modèle. Et parfois, l'expérience montre simplement que les informations disponibles ne suffisent pas. C'est aussi un résultat.
Vous vous souvenez de la réponse du début : chien 80 %, chat 15 %, loup 3 %. Un grand modèle de langage (un LLM) fait exactement la même chose, avec des mots.
On lui donne le début d'une phrase : « Le feu… ». Il répond : brûle 70 %, s'éteint 12 %, rouge 8 %… Il choisit un mot, l'ajoute, et recommence. Mot après mot, il écrit une réponse entière.
Le principe ne change pas : des boutons réglés par l'entraînement, une réponse en pourcentages. Et les mêmes leçons s'appliquent :
Vous n'avez pas eu à régler vous-même des millions de boutons. Mais vous savez comment ils sont réglés, et quelles questions poser avant de faire confiance à la machine.
Un premier modèle simple n'a rien de sorcier : un développeur peut le construire avec des outils existants, sans calculer la moindre dérivée. Le vrai travail est ailleurs : choisir la bonne question, préparer des données fiables et organiser un examen honnête.
Avant notre prochaine session, cherchez dans votre entreprise un fichier qui contient déjà des fiches et leur réponse connue :
Puis posez-vous trois questions :
Si vous avez une réponse aux trois, vous tenez peut-être votre première expérience d'IA.
1. Sur quelles données a-t-il été entraîné ? Variées, sans doublons, couvrant les situations réelles et pas seulement les plus courantes.
2. Comment a-t-il été testé ? Sur des cas mis de côté qu'il n'a jamais vus, et pas seulement sur ses exercices.
3. Quelles erreurs commet-il, et que coûtent-elles ? Un score global peut cacher une machine inutile sur les cas qui comptent.
4. Ses critères étaient-ils connus au moment de prédire ? Une donnée qui vient du futur fait briller le test et s'effondrer la production.
5. Que ne voit-il pas ? Ce qu'aucun critère ne lui dit, il ne peut pas le deviner.
Samuel Arnod-Prin, architecte de données et d'IA chez Agilbility. 27 ans à concevoir des plateformes orientées données pour Swatch Group, LVMH, Richemont et l'EPFL. Son profil →
Préparer des données fiables et organiser un examen honnête : la base de toute première expérience de prédiction dans votre entreprise.
Découvrir →le service qui répondPrédire les retards de vos projets commence par des fiches projet fiables, connues au bon moment. Analyse d'impact du portefeuille en 5 jours.
Découvrir →Tester une première prédiction sur vos données ? Écrivez-nous ou prenez 30 minutes →
C'est un ensemble de petites unités reliées entre elles, chacune avec des réglages, comme des boutons. L'entraînement compare la réponse de la machine à la bonne réponse, mesure l'écart, puis tourne légèrement les boutons pour le réduire. Répété sur des milliers d'exemples, cela permet à la machine de répondre en pourcentages sur des cas nouveaux.
Parce qu'il prédit, il ne sait pas. Il ne voit que les critères qu'on lui donne, peut manquer d'exemples pour certaines situations, apprendre ses exercices par cœur (surapprentissage) ou s'appuyer sur une donnée qui ne serait pas connue au moment de prédire.
C'est quand la machine apprend ses exemples d'entraînement par cœur au lieu de comprendre ce qui distingue les cas. Elle est brillante à l'entraînement et décevante sur de nouveaux cas. C'est pour le détecter qu'on garde des exemples de côté pour un examen.
Un LLM est un très grand réseau de neurones qui fait la même chose avec des mots : à partir du texte déjà écrit, il donne des pourcentages pour le mot suivant, en choisit un et recommence. Les mêmes leçons s'appliquent : il peut se tromper avec assurance et ne connaît pas ce qu'on ne lui a jamais montré.
La newsletter de Samuel Arnod-Prin : organiser vos données, vos connaissances, vos règles et vos processus pour que l'IA les comprenne et les exploite.