L'essentiel en 3 points
1. Un LLM découpe votre texte en morceaux (tokens), les fait circuler dans une succession de couches qui les mettent en relation (attention), puis choisit le morceau suivant. Et recommence.
2. Ses réglages (paramètres) sont figés à l'entraînement : il ne connaît ni vos clients, ni vos produits, ni vos règles. Tout ce qu'il sait de votre entreprise, c'est ce que vous lui donnez.
3. Une suite vraisemblable n'est pas une suite vraie. Une règle métier qui n'est écrite nulle part produit une réponse fluide et fausse : vos données sont votre meilleur levier.
Montons dans un petit train pour voir ce qui se passe vraiment entre votre question et sa réponse.
Pressé ? Allez directement à la dernière section, « 4 conséquences directes pour votre entreprise ».
Vous écrivez : « Le chat dort sur le… »
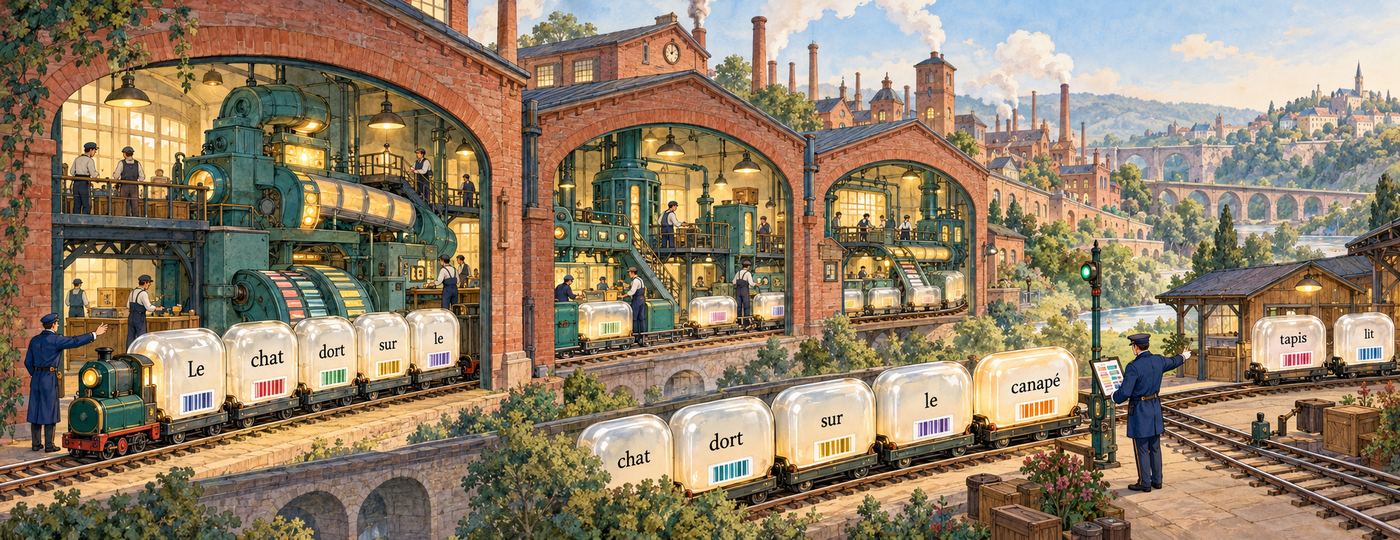
Dans les coulisses, un petit train transporte les morceaux de votre phrase dans des capsules.
Il traverse une succession d'usines. Dans chacune, des équipes et des machines retravaillent les informations inscrites sur les capsules.
À l'arrivée, un chef de gare consulte le résultat du voyage. Devant lui, plusieurs nouvelles capsules attendent : « canapé », « tapis », « lit »…
Il en choisit une pour prolonger la phrase. Pour continuer, le train repart pour un nouveau voyage.
Toute cette chaîne sert à choisir le prochain morceau de texte.
Au départ, notre phrase arrive au guichet de la gare : « Le chat dort sur le… »
Un préparateur la découpe en petits morceaux. Il place chaque morceau dans une capsule, puis accroche les capsules les unes derrière les autres, dans le même ordre.
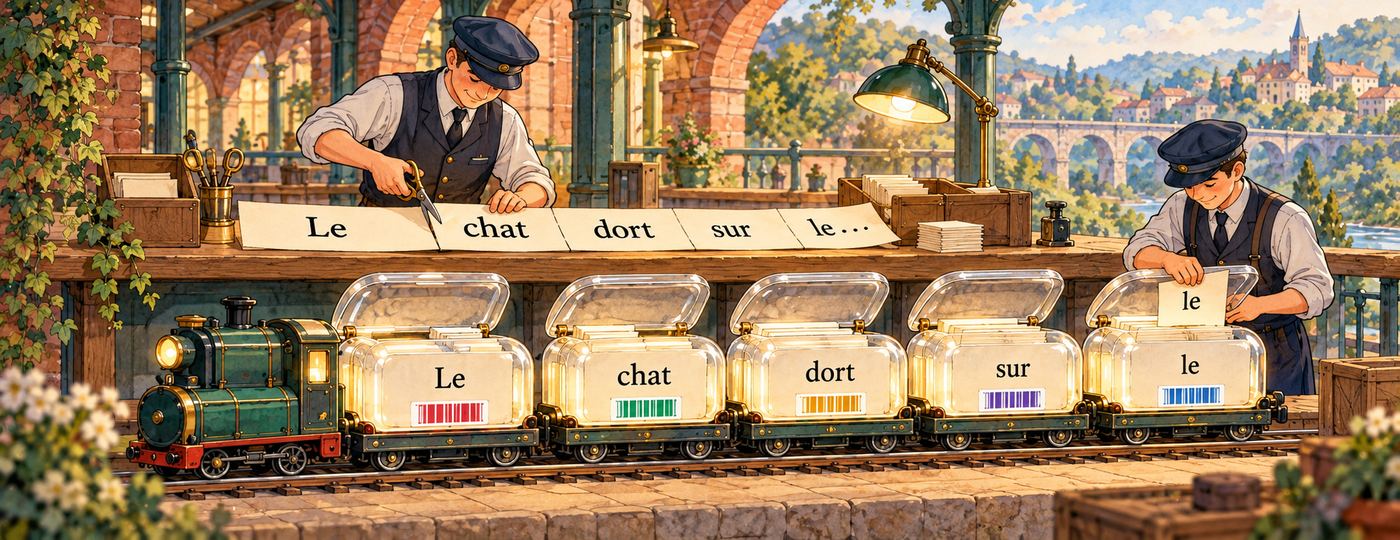
Mais attention : une capsule ne transporte pas forcément un mot entier ! Un mot peut être réparti dans plusieurs capsules. Même les signes de ponctuation ont leur place.
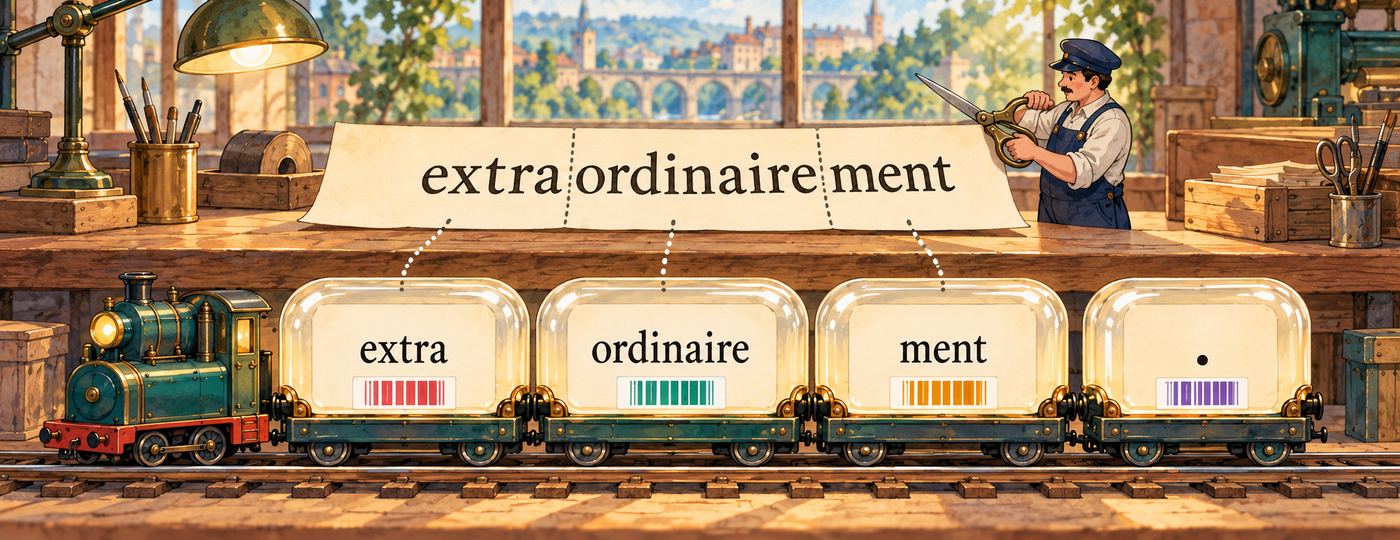
Le train transporte toute la phrase, morceau par morceau.
Une capsule peut contenir un mot, un fragment ou un signe.
Les capsules sont prêtes, mais les machines de nos usines ne savent pas travailler directement avec les lettres.
À la gare, un opérateur consulte un grand casier de correspondances. Pour chaque morceau de texte, il retrouve une bande de marques et la fixe sur la capsule.
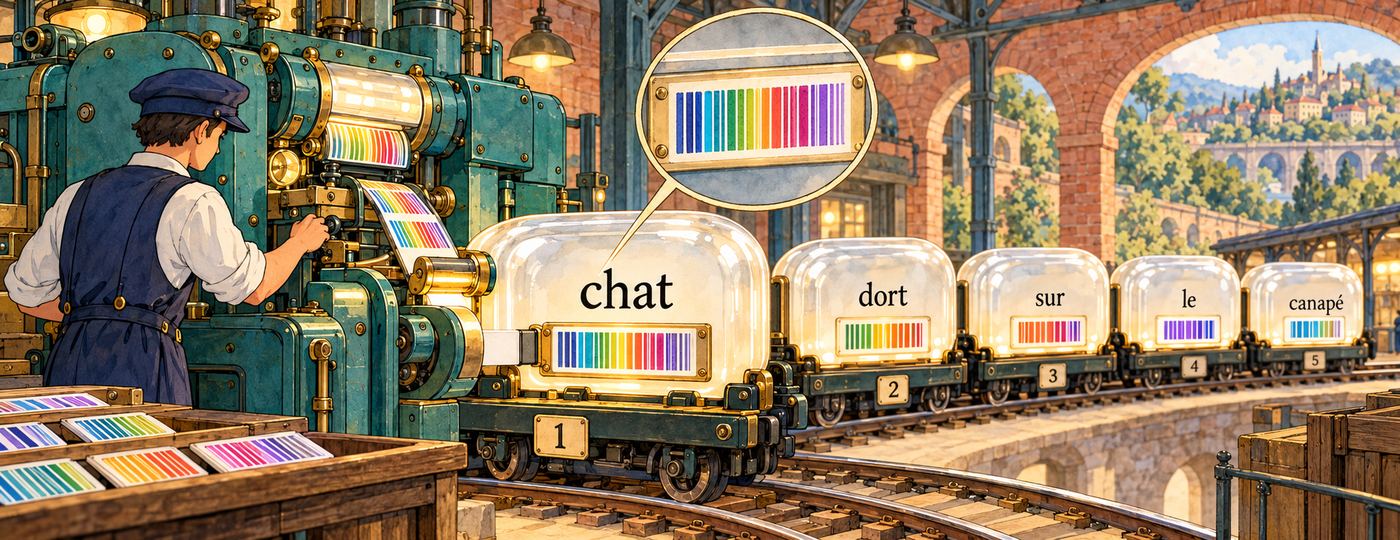
Cette bande ressemble à un code-barres très détaillé. Les machines pourront la lire et la modifier pendant le voyage.
Il faut aussi pouvoir reconnaître la place de chaque capsule. « Le chat suit le chien » ne raconte pas la même histoire que « Le chien suit le chat ».
Le morceau de texte reste visible pour nous. Dans les ateliers, ce sont les marques qui servent au travail.
Les machines travaillent sur des représentations des morceaux de texte.
La première usine ouvre ses portes. À l'intérieur, plusieurs équipes attendent autour de leurs établis.
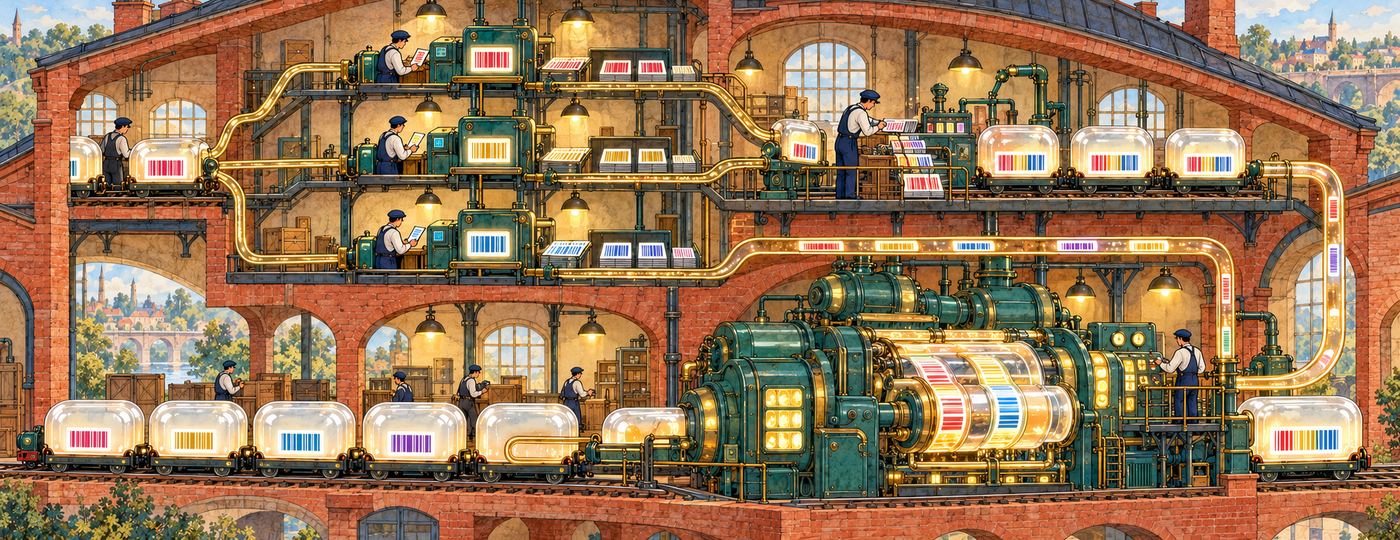
Un répartiteur leur transmet des copies des informations portées par les capsules. Chaque équipe prépare sa contribution, puis un assembleur réunit leurs résultats pour chaque capsule.
Une grosse machine reprend ensuite le travail. Nous découvrirons bientôt ses engrenages.
À la sortie, les capsules gardent leur place et leur morceau de texte. Leurs marques ont changé. La prochaine usine recevra ce résultat.
Une usine fait circuler les informations, puis les transforme.
Sur chaque chaîne, une équipe cherche quelles capsules peuvent apporter des informations utiles à celle qu'elle examine.
Les équipes disposent des mêmes capsules, mais leurs outils ont reçu des réglages différents. Elles peuvent donc préparer des contributions différentes.
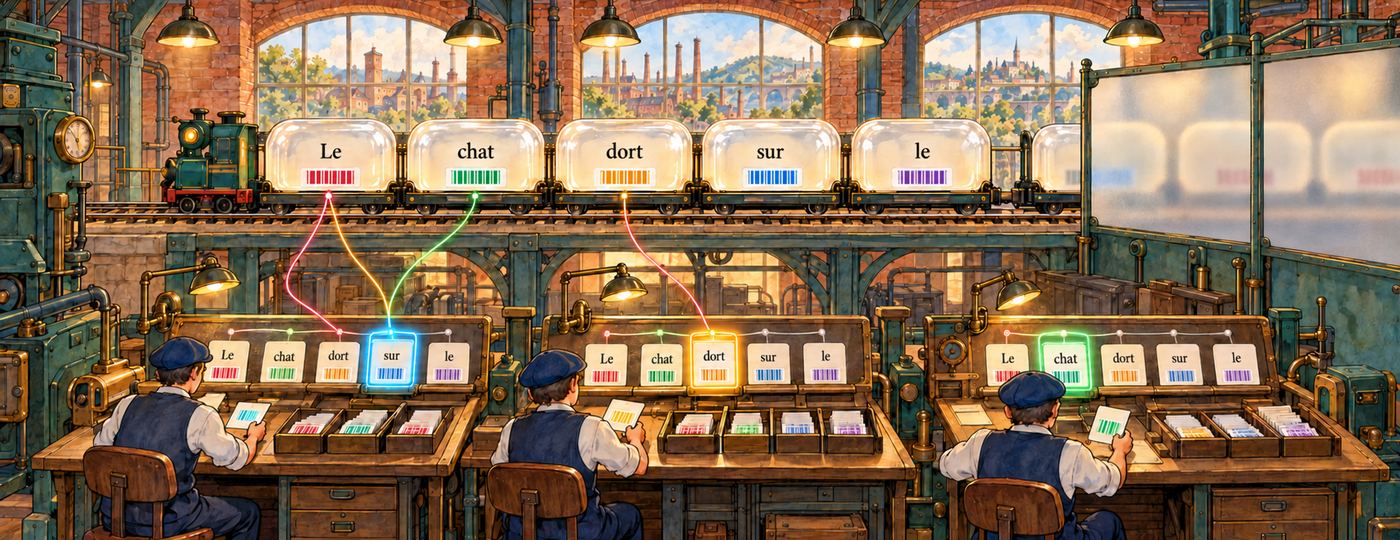
Une équipe ne se limite pas au wagon voisin : elle peut établir une liaison avec une capsule beaucoup plus loin derrière.
Dans notre train qui construit sa suite, les équipes peuvent consulter la capsule étudiée et celles qui la précèdent. Un rideau cache celles qui viendront après.
Chaque équipe prépare un résultat pour chaque capsule traitée. Aucune ne fabrique, à elle seule, un résumé unique de tout le train.
Plusieurs équipes examinent les relations en parallèle.
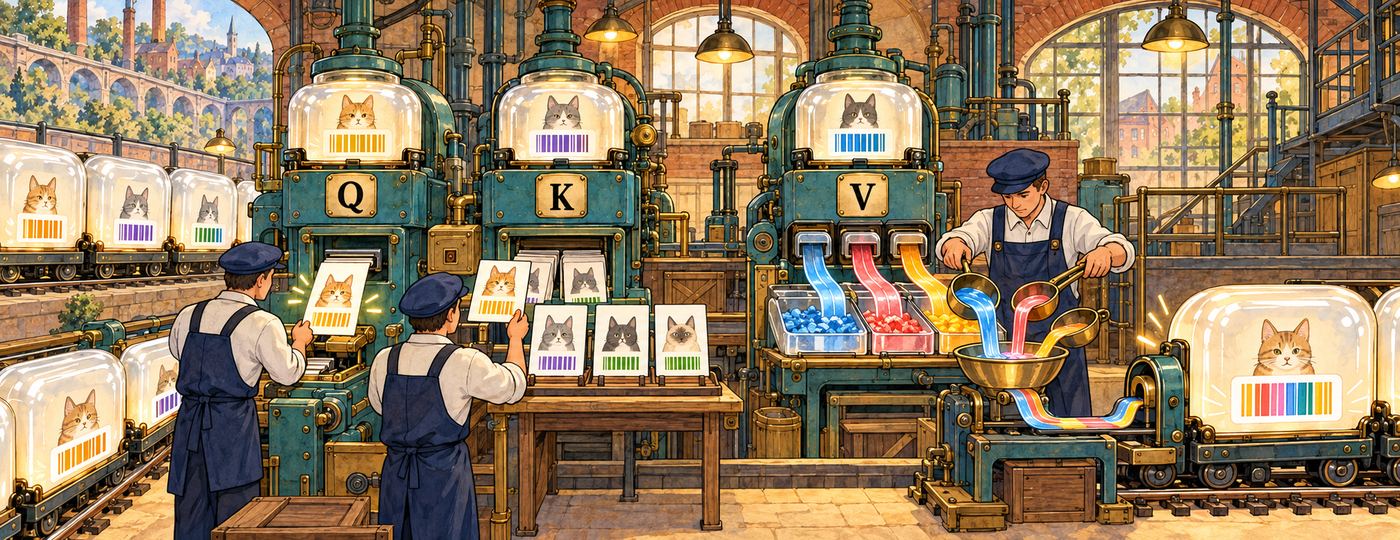
Pour chaque capsule, une équipe de liaison se pose une question : parmi les capsules précédentes, lesquelles m'apportent quelque chose d'utile ? Elle compare ce qu'elle cherche à ce que chacune offre, puis attribue une dose à chacune. Dans « Le chat dort sur le… », la capsule « le » puise surtout dans « dort » et « sur » : on s'apprête à nommer un endroit.
Les doses prélevées sont mélangées. Ce mélange devient la contribution de l'équipe.
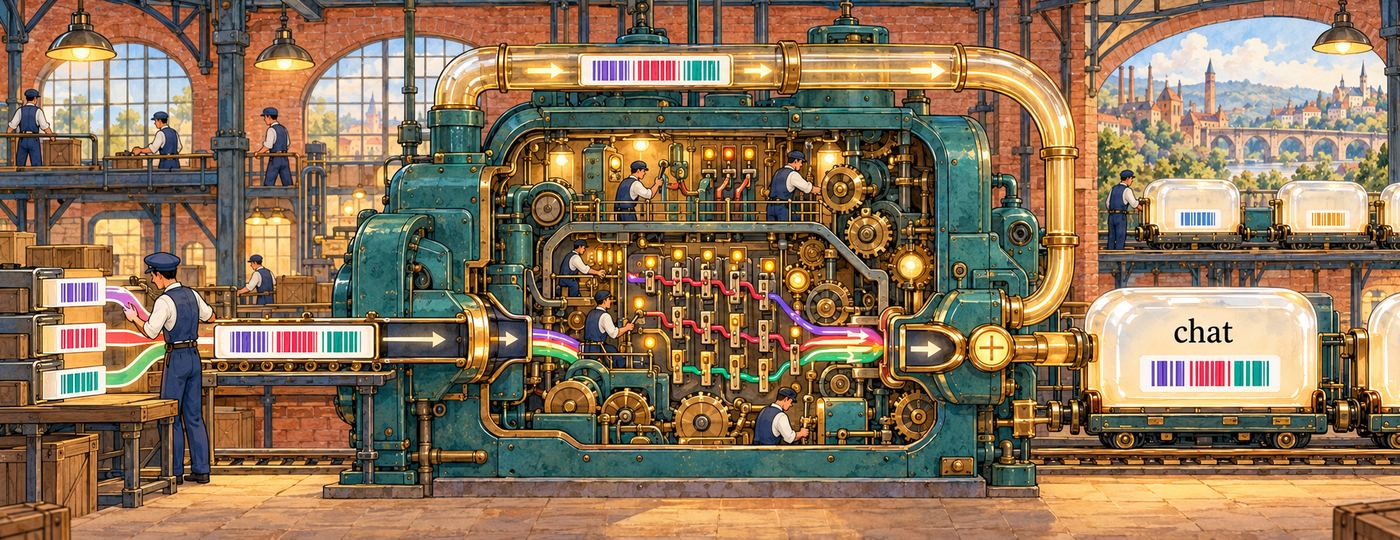
Les contributions de toutes les équipes sont réunies, puis chaque capsule passe seule dans une grande machine. Celle-ci ne regarde plus les autres wagons, car les équipes l'ont déjà fait. Elle retravaille ce que la capsule a récolté et en tire des combinaisons nouvelles, comme « endroit confortable où dormir ».
Les liaisons apportent du contexte ; la grande machine le retravaille.
Le train traverse d'autres usines. Chacune reçoit les marques produites jusque-là et poursuit le travail avec ses propres réglages.
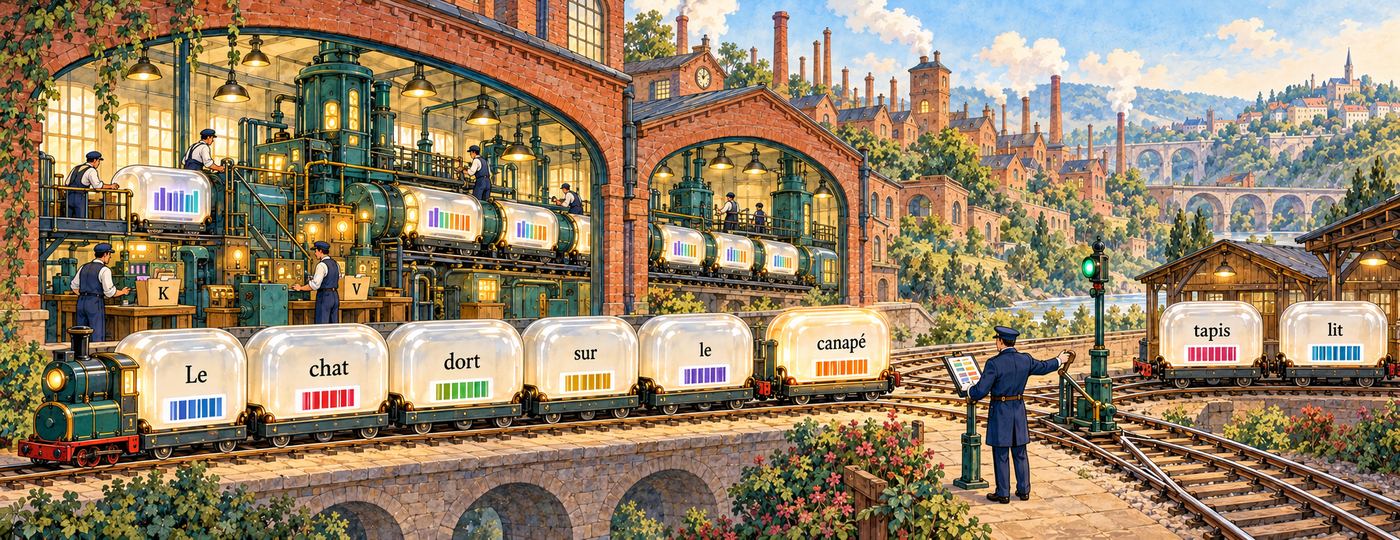
Au terminus, le chef de gare consulte les dernières marques de la dernière capsule. Son tableau attribue des chances aux différents morceaux de texte disponibles.
« Canapé », « tapis », « lit » : plusieurs suites peuvent convenir. L'aiguilleur choisit une capsule, puis l'ajoute au train.
Pour choisir la suivante, on reprend le travail. Heureusement, chaque usine conserve des fiches des passages précédents : elle peut s'en resservir et traiter la nouvelle capsule.
La réponse se construit ainsi jusqu'au signal de fin ou à une autre limite du trajet.
La réponse grandit par choix successifs, avec réutilisation du travail passé.
Avant l'ouverture au public, les usines ont connu une longue période d'essais.
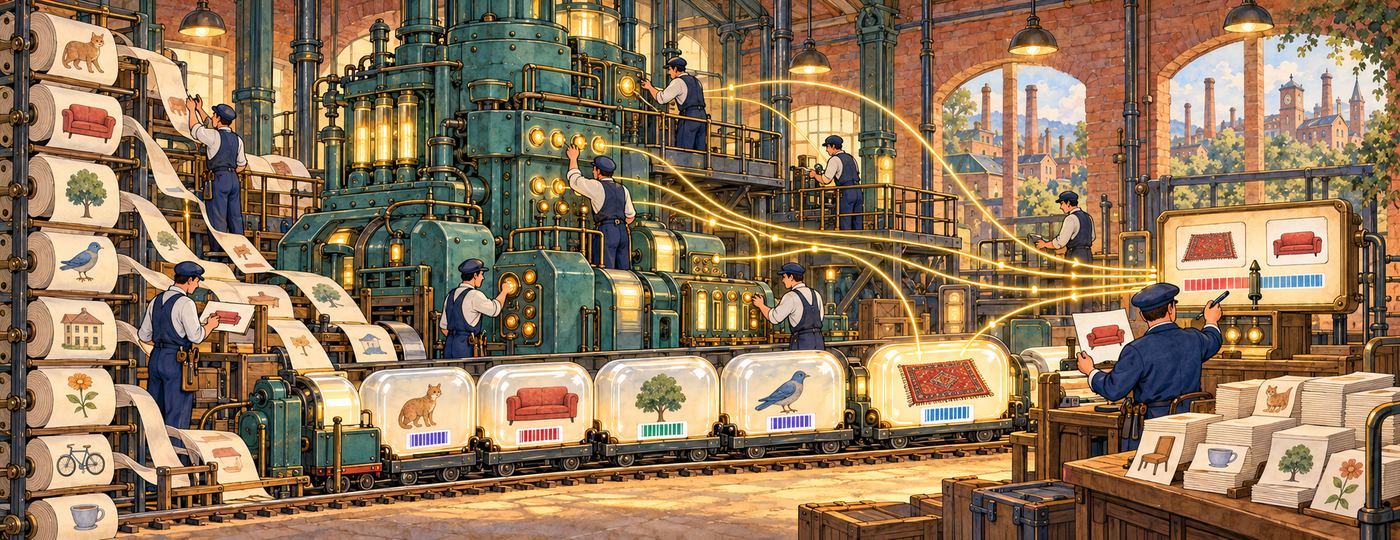
Les formateurs présentaient des débuts de textes et gardaient leur suite comme exemple. Les usines proposaient leurs prochaines capsules. Un contrôleur mesurait l'écart avec la suite attendue.
Des signaux revenaient alors vers les ateliers pour ajuster de très nombreux réglages. Puis l'exercice recommençait sur d'autres textes.
Les machines ont ainsi appris des régularités, des associations et des façons de composer le langage.
Quand nous utilisons le train ordinaire, ces réglages restent habituellement fixes. Les capsules de notre conversation apportent un contexte de travail, sans reconstruire toutes les machines.
Apprendre change les réglages ; utiliser le modèle change ses informations de travail.
Le chef de gare sait assembler des suites qui ressemblent aux textes rencontrés pendant les essais. Mais son tableau de chances ne certifie pas ce qu'elles racontent.
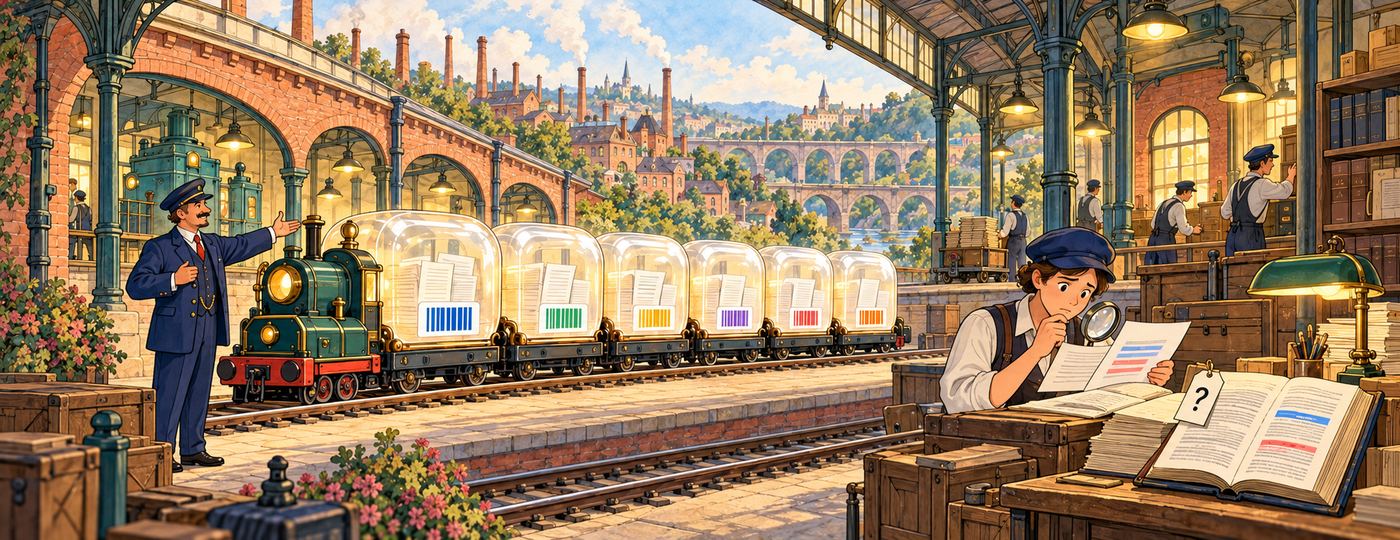
Un train peut être très élégant et porter une mauvaise destination. Une réponse fluide peut, elle aussi, contenir une erreur ou inventer un détail.
Pour un travail important, un lecteur doit donc comparer le résultat à des références fiables.
On peut aussi apporter des documents au guichet avant le départ. Les équipes disposent alors de nouvelles capsules à consulter. Cela les aide, sans garantir que chaque liaison et chaque choix seront bons.
Nous connaissons maintenant le voyage : préparer les capsules, faire circuler et transformer leurs informations, puis choisir une suite. À nous d'en vérifier la destination.
La vraisemblance d'une suite ne garantit pas sa vérité.
Toute cette organisation pour finalement prédire le prochain morceau de texte ! Mais où est l'intelligence ?
Mettons dans le petit train : « J'ai froid, je suis devant ma cheminée. Que puis-je faire ? »
Les capsules de la réponse pourraient progressivement former : « Fais du feu dans ta cheminée pour te réchauffer. »
Difficile à admettre : comment une fabrique de suites de texte peut-elle proposer une action adaptée à une situation ?
Parce que, pendant leur apprentissage, les usines n'ont pas seulement appris quelles expressions se suivent souvent. Leurs réglages leur permettent aussi de mettre en relation des informations : le froid, le besoin de chaleur, la cheminée et la possibilité d'y allumer un feu.
Prédire la suite est leur mission. Combiner les informations pour trouver cette suite peut demander un raisonnement.
Ajoutons maintenant une contrainte : « J'ai froid, je suis devant ma cheminée, mais son conduit est condamné. Que puis-je faire ? »
Une simple association entre « froid », « cheminée » et « feu » conduirait à une mauvaise proposition. Une réponse adaptée doit tenir compte de la contrainte et chercher une autre solution.
Les premiers modèles apprenaient déjà certaines relations. Avec davantage de capacité, de données et de calcul pendant l'entraînement, les modèles ont développé des capacités plus élaborées. Des entraînements supplémentaires consacrés à la résolution de problèmes ont renforcé certaines d'entre elles.
Ils continuent à produire du texte morceau par morceau. Mais le travail qui permet de choisir ces morceaux peut aller de l'association familière à une résolution en plusieurs étapes, avec, toujours, la possibilité de se tromper.
1. Vous payez à la capsule. Les fournisseurs facturent au token. Envoyer des documents entiers « au cas où » coûte cher et noie l'information utile.
2. Le train n'apprend pas de vous. Ses réglages sont figés : il ne connaît ni vos clients, ni vos produits, ni vos règles. Tout ce qu'il sait de votre entreprise, c'est ce que vous déposez au guichet. Vos données sont donc votre meilleur levier.
3. Une réponse élégante n'est pas une réponse vérifiée. Décidez à l'avance où un humain contrôle, et sur quelles références.
4. Le conduit condamné, c'est votre règle métier. Si personne n'a écrit que le conduit est bouché, le modèle propose d'allumer le feu. C'est pareil dans votre entreprise : un délai de livraison qui ne vaut que pour la Suisse, un rabais réservé à certains clients… Une règle qui ne vit que dans la tête de vos collaborateurs produit une réponse fluide et fausse.
Préparer son entreprise pour l'IA, c'est d'abord soigner ce qu'on met dans les capsules. Ce sera le sujet du prochain article.
Quelle règle de votre entreprise n'est écrite nulle part ?
1. Qu'est-ce que je dépose au guichet ? Les documents utiles, pas tout le dossier « au cas où ». Moins de capsules inutiles, c'est moins cher et plus précis.
2. Quelles règles sont écrites ? Délais, rabais, exceptions clients : si une règle n'existe que dans la tête de quelqu'un, le modèle ne peut pas la respecter. Écrivez-la avant.
3. Qui vérifie, et sur quelles références ? Décidez à l'avance quel résultat est relu par un humain, et avec quelle source qui fait foi.
Samuel Arnod-Prin, architecte de données et d'IA chez Agilbility. 27 ans à concevoir des plateformes orientées données pour Swatch Group, LVMH, Richemont et l'EPFL. Son profil →
Préparer ce que vous mettez dans les capsules : données fiables, règles métier écrites, graphe de connaissances, pour une IA qui exploite vraiment votre métier.
Découvrir →le service qui répondFormer vos équipes à utiliser l'IA sur leurs vraies tâches : formuler, vérifier, transmettre. 3 h en entreprise, dès 1'950 CHF.
Découvrir →Préparer ce que votre IA doit savoir de votre entreprise ? Écrivez-nous ou prenez 30 minutes →
Un LLM découpe le texte en morceaux appelés tokens, les traduit en représentations numériques, les fait passer dans une succession de couches où un mécanisme d'attention met chaque morceau en relation avec les précédents, puis attribue des chances aux morceaux suivants possibles et en choisit un. Il recommence jusqu'à la fin de la réponse.
Non, en usage ordinaire. Ses paramètres sont fixés pendant l'entraînement. Ce que vous lui donnez dans la conversation sert de contexte de travail pour cette réponse, sans modifier le modèle. Il ne connaît donc de votre entreprise que ce que vous lui fournissez.
Parce qu'il produit la suite la plus vraisemblable, pas une suite vérifiée. Une réponse fluide peut contenir une erreur ou un détail inventé. Pour un travail important, il faut comparer le résultat à des références fiables.
Un token est un morceau de texte : un mot, un fragment de mot ou un signe. Les fournisseurs facturent au token. Envoyer des documents entiers au cas où coûte plus cher et noie l'information utile.
 Data & IA · 13 octobre 2026
Le fonctionnement d'un LLM expliqué avec un petit train, sans jargon.
Lire → Données & ERP · 6 octobre 2026
Le savoir implicite, un risque qui n'apparaît dans aucun tableau de bord.
Lire →La newsletter de Samuel Arnod-Prin : organiser vos données, vos connaissances, vos règles et vos processus pour que l'IA les comprenne et les exploite.